
Alertas y notificaciones IoT industriales: cómo diseñarlas para que se atiendan
Preguntas frecuentes
¿Cuántas alertas debería tener un sistema?
Las que el equipo pueda atender y cerrar. Si la mayoría se ignora, el problema es el diseño, no la cantidad de sensores.
¿Qué diferencia hay entre monitoreo y alertas?
El monitoreo muestra el estado y el histórico. Las alertas convierten un desvío en una acción notificada a un responsable. Un sistema puede monitorear sin alertar, pero no debería alertar sin un responsable.
¿Se puede usar SMS, email y llamadas?
Sí, según la severidad y la criticidad. Lo importante es que el canal tenga sentido para la urgencia y que exista escalamiento cuando no hay reconocimiento.
¿Qué pasa si se corta la conexión?
El diseño debe definir buffer local, reintento, sincronización y una alerta de comunicación. La pérdida de datos también es un evento que debe detectarse.
¿Las alertas reemplazan el mantenimiento predictivo?
No. Las alertas basadas en umbrales son mantenimiento basado en condición. La predicción requiere historial, variable relacionada con el modo de falla y un método validado.
En este artículo
Un sensor que mide no es una alerta. Una alerta es una decisión operativa: alguien tiene que saber qué pasó, qué tan urgente es, qué debe hacer y en cuánto tiempo. Si el sistema no responde esas preguntas, el equipo aprende a ignorarlo.
Diseñar alertas IoT industriales es diseñar un flujo de responsabilidad. El sensor es solo la fuente del dato.
Evento, alarma y alerta: no son lo mismo
- Evento: algo ocurrió y quedó registrado (una puerta se abrió, una temperatura subió).
- Alarma: el evento cruzó un umbral definido y requiere atención.
- Alerta: la alarma se comunicó a la persona correcta, por el canal correcto, con contexto para actuar.
Un dashboard lleno de eventos no reemplaza una alerta. La diferencia está en la acción esperada.
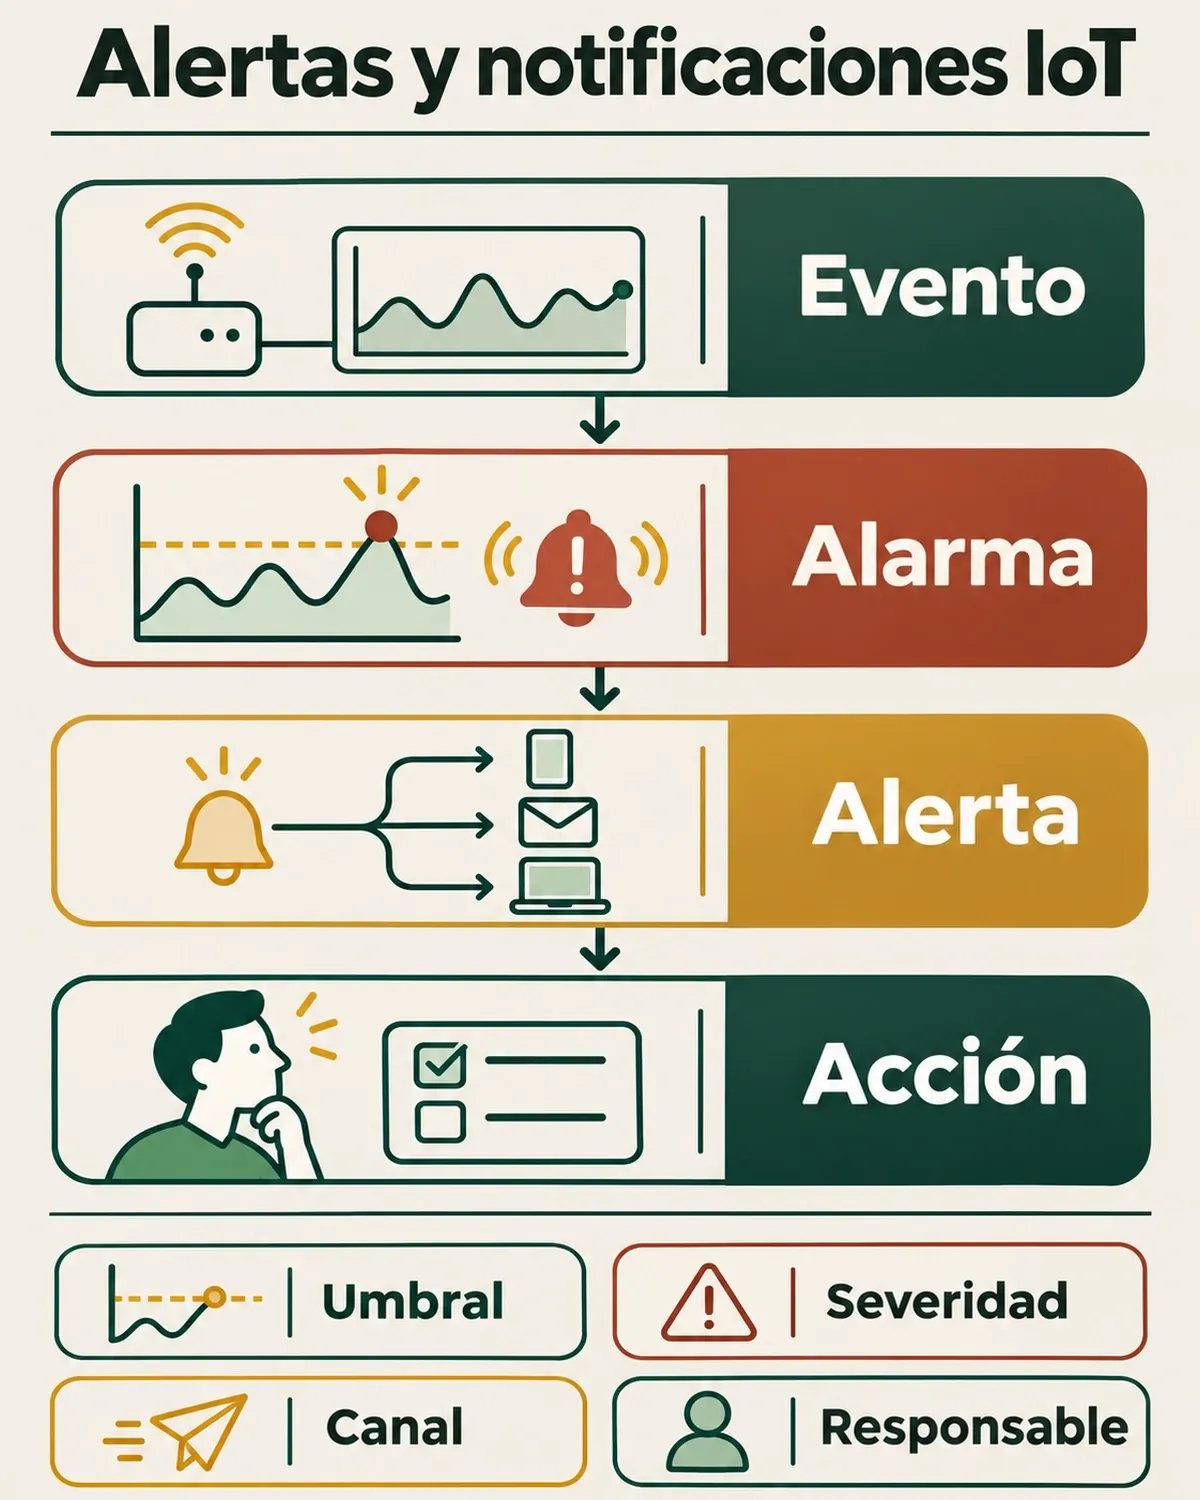
Una alerta útil conecta el dato con un responsable y una acción concreta.
Qué definir antes de configurar una alerta
- Variable y condición. Qué se mide, en qué rango y durante cuánto tiempo.
- Umbral. Valor, histéresis y tiempo de confirmación para evitar falsos positivos.
- Severidad. Informativa, advertencia, crítica o parada.
- Responsable. Quién recibe, quién escala y quién cierra la alerta.
- Canal. SMS, email, push, llamada, tablero o integración con mantenimiento.
- Tiempo de respuesta. Qué se espera en 5 minutos, en 1 hora y en el próximo turno.
- Registro. Qué se guarda para analizar recurrencia y mejorar el umbral.
Canales y escalamiento
No todas las alertas merecen una llamada. Una alerta informativa puede ir al tablero; una crítica puede requerir SMS, llamada y escalamiento si no se reconoce en un tiempo definido. El canal debe corresponder a la urgencia y a la forma de trabajo del equipo.
El escalamiento evita que una alerta quede en un teléfono que nadie mira. También evita que todo escale a todos: cuando una alerta crítica se envía siempre a cinco personas, ninguna se siente responsable.
Fatiga de alertas y falsos positivos
La fatiga aparece cuando el sistema genera más alertas de las que el equipo puede atender. Las causas más comunes son umbrales mal calibrados, falta de histéresis, sensores ruidosos y alertas duplicadas.
Para reducirlas:
- separar alertas críticas de informativas;
- usar tiempo de confirmación antes de notificar;
- agrupar alertas relacionadas;
- revisar semanalmente las que se ignoran;
- documentar qué acción cerró cada alerta.
Un sistema con pocas alertas útiles genera más confianza que uno con muchas alertas “por si acaso”.
Monitoreo en tiempo real: qué significa
“Tiempo real” no significa lo mismo para todos. Para una parada crítica puede ser segundos; para una tendencia de temperatura, minutos u horas. Definir la latencia aceptable evita sobredimensionar la conectividad y el costo.
También hay que definir qué pasa cuando se corta internet o se pierde la red: buffer local, reintento, dato faltante y alerta de comunicación. Un sistema que no avisa cuando deja de recibir datos puede dar una falsa tranquilidad.
Métricas para saber si funciona
- tiempo entre el evento y la notificación;
- porcentaje de alertas atendidas;
- porcentaje de falsos positivos;
- tiempo de reconocimiento y cierre;
- alertas repetidas por la misma causa;
- incidentes evitados o detectados antes de una falla mayor.
Cómo diseñar umbrales e histéresis
El diseño del umbral debería empezar por una pregunta: ¿qué decisión habilita esta alerta? Si la respuesta es “alguien debería mirarlo”, probablemente sea informativa. Si la respuesta es “alguien tiene que parar la línea”, el umbral, el canal y el escalamiento deben ser mucho más estrictos.
Un umbral bien elegido separa el ruido de la señal. Si el sensor tiene variaciones normales, una alerta que dispara con cualquier pico genera desconfianza. La histéresis evita que la alerta se active y desactive repetidamente cerca del límite; el tiempo de confirmación exige que el desvío se sostenga antes de notificar.
Para calibrar:
- registrá el comportamiento normal durante varios turnos;
- identificá la variación esperada y los picos repetitivos;
- definí el valor que realmente indica un problema;
- probá el umbral con datos históricos;
- revisalo después de las primeras semanas.
Un umbral no es una verdad permanente. Cambia con el producto, el mantenimiento y la estación del año. Documentar por qué se eligió permite ajustarlo sin empezar de nuevo.
Escalamiento, turnos y cierre
Una alerta crítica no puede depender de que una persona mire el teléfono. El escalamiento define qué pasa si no hay reconocimiento en un tiempo determinado: se notifica al siguiente responsable, se activa una llamada o se detiene el proceso según el riesgo.
También hay que definir el cierre. Una alerta no se cierra porque el valor volvió a la normalidad; se cierra cuando alguien confirmó la causa y la acción. Si no, el problema reaparece y el historial se vuelve inútil.
En operaciones con turnos, el traspaso debe incluir las alertas abiertas, lo que se hizo y lo que queda pendiente. La alerta que nadie hereda es una alerta que se pierde.
Matriz de alertas por severidad
| Severidad | Ejemplo | Canal | Respuesta esperada |
|---|---|---|---|
| Informativa | Cambio de turno, tendencia leve | Tablero o email | Revisión en el turno |
| Advertencia | Temperatura fuera de rango | Email, push o SMS | Acción en la hora |
| Crítica | Parada, fuga o riesgo de seguridad | SMS y llamada | Acción inmediata y escalamiento |
| Emergencia | Riesgo para personas o instalación | Llamada y protocolo | Parada y respuesta definida |
La matriz debe acordarse con operaciones y mantenimiento, no imponerse desde el sistema. Si el equipo no puede sostener la respuesta, la severidad está mal definida.